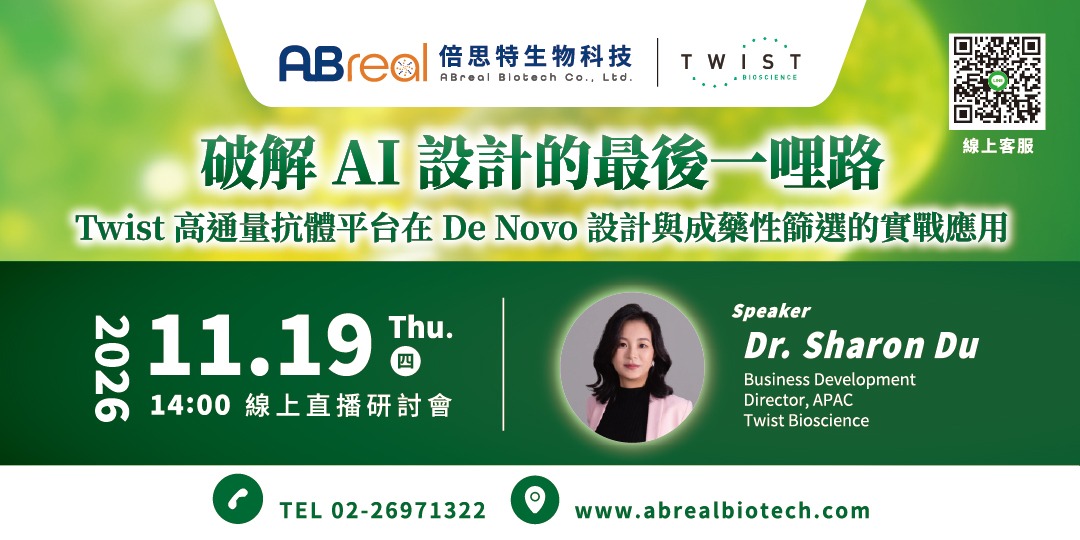
隨著生成式 AI 快速進入抗體藥物開發領域,如何對電腦設計出的候選分子進行大規模、高準確度的濕實驗驗證,已成為決定 AI 藥物能否順利推向臨床的關鍵。
Twist Bioscience 憑藉獨家矽晶片 DNA 合成技術與自動化高通量抗體平台,已成為全球頂尖 AI 團隊與科技巨擘不可或缺的「乾濕閉環(Design-Build-Test-Learn Loop)」實體驗證引擎。
本研討會將解析三大指標性合作實例:
1. LLM自主設計與極速驗證
- 案例分享:分享 Anthropic 如何利用其 Claude AI 模型自主針對 15 個標靶設計出超過 1,200 個 de novo 蛋白結合分子;Twist Bioscience 在不到 3 週內完成從序列到實驗數據的高通量合成與表徵驗證,在 14 個標靶上成功確認結合分子,締造 22–35%的高命中率 (遠高於傳統10–15%),並在 6個以上標靶獲取 sub-10 nM 的高親和力結合分子。
- 您將學到:了解頂尖 AI 團隊如何運用高通量實體驗證,打破傳統乾濕實驗的時間壁壘,將大模型演算極速轉化為可驗證的實體藥物分子。
2. AI/ML 基準數據庫基石
- 案例分享:解密 Twist 為 AWS (Amazon Web Services) 與 Johns Hopkins大學 (Gray Lab) 發布Amazon Bio Discovery 數據庫提供 50 個標靶、5,000 個序列、70,000+ 實驗數據點,奠定 AI 訓練黃金基石。
- 您將學到:參考業界標竿如何運用高品質、標準化的濕實驗數據庫,進行自有 AI/ML 模型的構建、微調 (Fine-tuning) 與性能評測。
3. 成藥性篩選與AI預測模型
- 案例分享:Twist 運用高通量蛋白生產與多維度分析 (SPR 親和力、AC-SINS 聚集、BVP-ELISA 脫靶檢測等),對 AI 預測分子進行成藥性篩選,並與牛津大學 Deane Lab合作將實驗數據轉化為開源預測工具 (TNP)。
- 您將學到:如何突破「電腦預測結合力強,實測卻易脫靶/聚集」的研發盲點,利用多維度表徵分析早期過濾高風險分子,全面提升抗體可開發性(Developability)。
Twist 與倍思特 將協助您的團隊打破乾濕實驗壁壘,加速下一代抗體藥物開發!