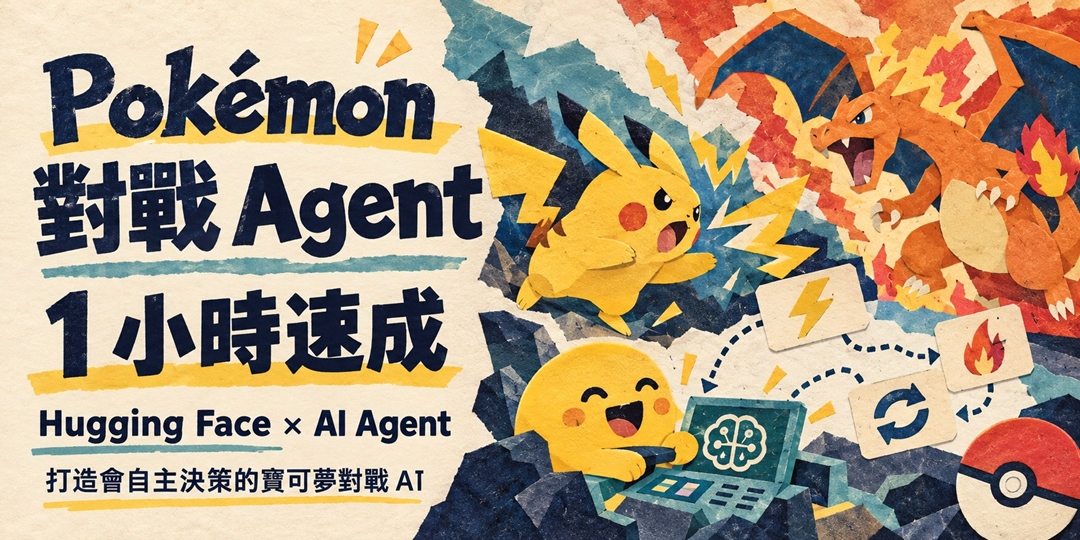
⚡ 你能打造一個自己判斷戰況、選擇招式,甚至決定何時換寶可夢的 AI 嗎?
這場 1 小時實作活動將以 Hugging Face Agents Course 🤗 為基礎,帶你結合大型語言模型(LLM)、Poke-env 與 Pokémon Showdown,透過預備好的程式範本,完成能自動進行寶可夢對戰的 AI Agent。🤖
過程中,你將理解 AI 如何讀取戰況、呼叫工具,以及將模型決策轉成遊戲中的合法行動,並透過對戰紀錄,觀察不同策略帶來的影響。
🎮 活動內容
🧠 認識 AI Agent 的觀察、決策與行動流程。
🔗 拆解對戰環境與大型語言模型的串接架構。
🛠️ 實作選擇招式與切換寶可夢的工具呼叫。
⚔️ 啟動自動對戰,觀察決策與錯誤處理。
📊 探索策略提示、歷史記憶與勝率評估的改善方向。
🙋 適合對象
對 AI Agent、LLM 應用或遊戲 AI 有興趣,具備基本 Python 閱讀與修改能力的學習者。
🎁 完成後,你將帶走
一份可持續修改的對戰 Agent 程式,以及將「讀取環境 → 模型決策 → 工具執行」應用到其他任務的實作經驗。🚀